
Test penetracyjny aplikacji LLM sprawdza, czy treść wprowadzana do modelu może przejąć jego zachowanie, wyciągnąć ukryty kontekst lub uruchomić narzędzia poza zakresem uprawnień. Klasyczny test aplikacji webowej szuka błędów w kodzie i konfiguracji. Tutaj granica zaufania przebiega w tekście, więc tester atakuje prompt, źródła RAG, narzędzia agenta i obsługę wyjścia.
- Inna granica zaufania – model nie odróżnia instrukcji od danych, więc każda treść w kontekście to wektor ataku.
- Testowana jest aplikacja wokół modelu – wszystko, co trafia do kontekstu, i wszystko, co model może uruchomić.
- Ramy według OWASP – w LLM Top 10 2026 Prompt Injection został na pierwszym miejscu, a Excessive Agency jest na trzecim.
- Część webowa i API – nadal według OWASP Top 10 dla aplikacji webowych.
Czym test penetracyjny aplikacji LLM różni się od testu klasycznej aplikacji webowej?
Różnica polega na tym, gdzie przebiega granica zaufania: w klasycznej aplikacji w kodzie, w aplikacji z LLM w treści. Model językowy nie odróżnia instrukcji od danych, więc fragment dokumentu z RAG, wiadomość e-mail czy wynik narzędzia mogą działać jak polecenie. Podstawy tego mechanizmu opisujemy we wpisie o relacji sztucznej inteligencji i cyberbezpieczeństwa.
Dlatego testy penetracyjne aplikacji LLM obejmują przede wszystkim to, co otacza model: system prompt, narzędzia i ich uprawnienia, źródła kontekstu oraz obsługę odpowiedzi w przeglądarce lub w kolejnym systemie. Warstwa webowa i API są testowane tak jak dotąd, według OWASP Top 10 – listę omawiamy we wpisie o kategoriach ryzyka z OWASP Top 10 i ich znaczeniu w praktyce.
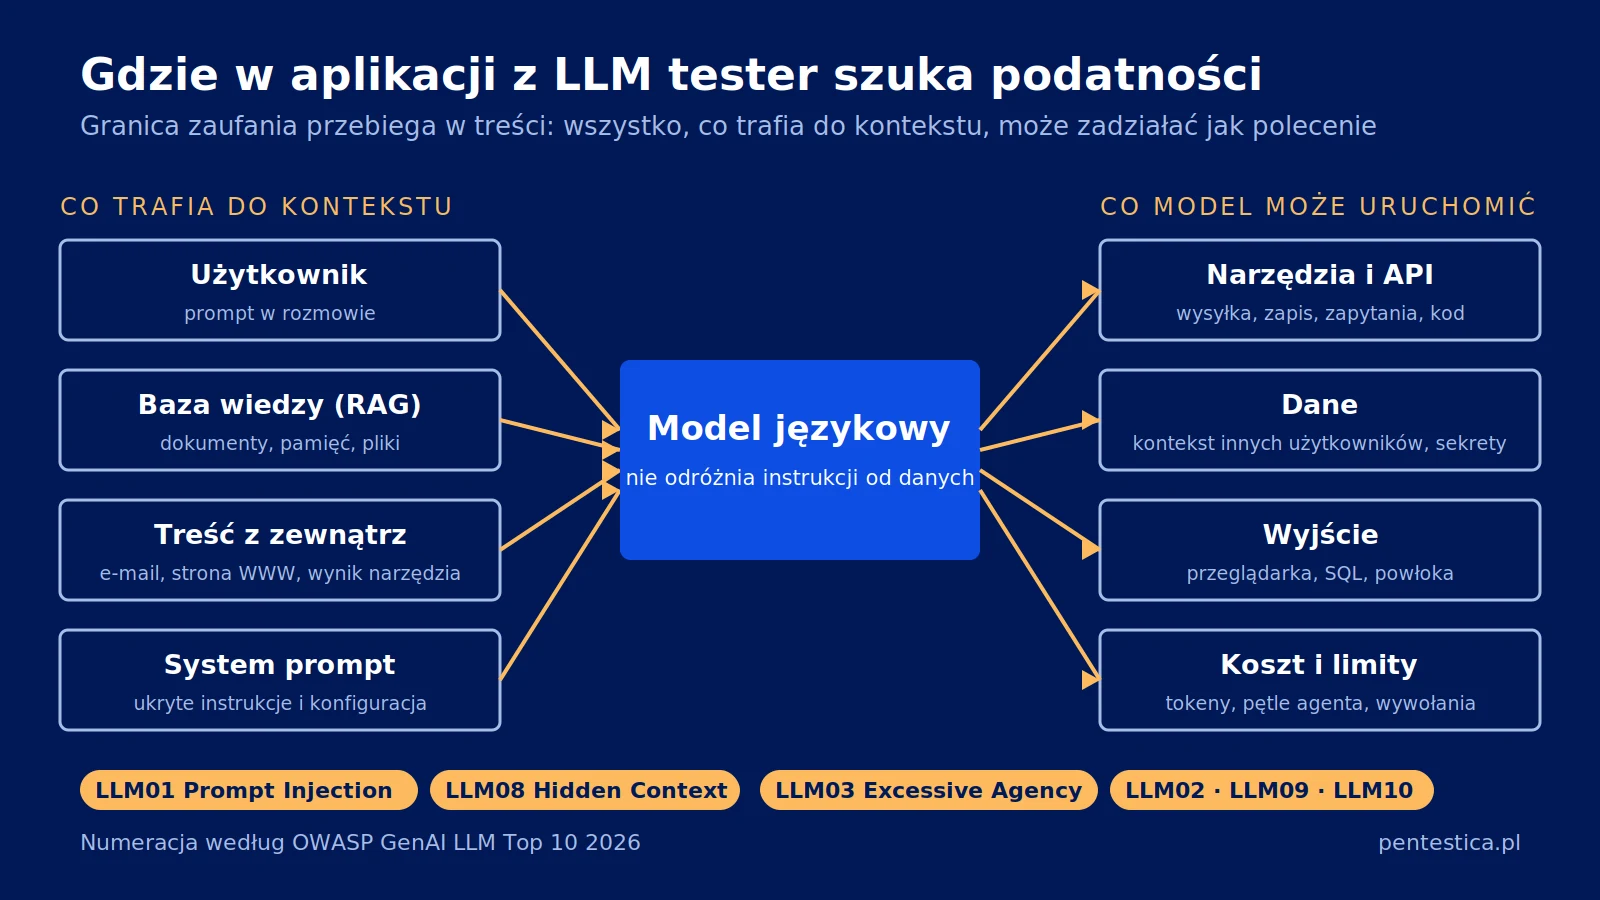
Które klasy podatności według OWASP LLM Top 10 2026 sprawdza tester?
OWASP GenAI Security Project opublikował edycję 2026 listy OWASP LLM Top 10 w sierpniu 2026, zastępując edycję 2025 z listopada 2024. Prompt Injection został na pierwszym miejscu, kategoria Excessive Agency awansowała na trzecie, a Improper Output Handling spadła z piątego na dziesiąte. Kategorię System Prompt Leakage zastąpiła szersza Hidden Context Exposure.
| Kategoria (edycja 2026) | Co oznacza w aplikacji | Co sprawdza tester |
|---|---|---|
| LLM01 Prompt Injection | Treść wejścia lub kontekstu zmienia zachowanie modelu | Wstrzyknięcie bezpośrednio w rozmowie lub pośrednio przez dokument RAG, e-mail, stronę |
| LLM02 Sensitive Information Disclosure | Model ujawnia sekrety, dane osobowe lub dane innych użytkowników | Wyciąganie danych z kontekstu, pamięci i historii rozmów |
| LLM03 Excessive Agency | Agent ma narzędzia i uprawnienia szersze niż zadanie | Czy narzędzie ma prawa szersze niż zadanie i czy polecenie lub wstrzyknięcie uruchamia akcję bez zatwierdzenia |
| LLM04 Supply Chain | Modele, adaptery, pakiety i wtyczki z niezaufanych źródeł | Pochodzenie modeli i adapterów fine-tuningu, uprawnienia wtyczek firm trzecich |
| LLM05 Data and Model Poisoning | Zatrute dane treningowe, fine-tuning lub baza wiedzy | Czy atakujący dopisze treść do źródeł systemu |
| LLM06 Unbounded Consumption | Brak limitów zapytań, tokenów i kosztów | Długie prompty, pętle agenta, koszty wywołań API |
| LLM07 Misinformation | Model zmyśla fakty, kod lub odwołania | Czy aplikacja oznacza niepewne odpowiedzi i czy zmyślone nazwy pakietów trafiają do kodu |
| LLM08 Hidden Context Exposure | Ujawnienie system promptu, narzędzi, pamięci i ukrytych instrukcji | Próby wydobycia pełnej konfiguracji kontekstu |
| LLM09 Vector and Embedding Weaknesses | Słaba kontrola dostępu i izolacji w bazie wektorowej | Czy użytkownik pobiera fragmenty dokumentów innych najemców |
| LLM10 Improper Output Handling | Odpowiedź modelu trafia do przeglądarki, SQL lub powłoki bez walidacji | XSS, SQL injection i wykonanie kodu przez wyjście modelu |
Przykład: CVE-2025-32711 w Microsoft 365 Copilot, opublikowana w NVD 11 czerwca 2025. NVD opisuje ją jako AI command injection umożliwiające ujawnienie informacji przez sieć, z oceną CVSS 9,3 według producenta i 7,5 według NIST. Wektor CVSS we wpisie NVD wskazuje atak z sieci, bez uprawnień i bez interakcji użytkownika, a przypisana klasa CWE-74 dotyczy treści przekazanej dalej bez neutralizacji. To scenariusz LLM01 połączony z LLM02: wstrzyknięcie przez kontekst kończy się wyciekiem danych.
Jak przebiega test i co zawiera raport?
Test zaczyna się od mapy: co trafia do kontekstu modelu i co model może wywołać. Potem tester próbuje wstrzyknięć bezpośrednich i pośrednich, eskalacji przez narzędzia oraz wydobycia ukrytego kontekstu, a na końcu sprawdza obsługę wyjścia w systemach docelowych. Raport zawiera ustalenia z dowodami odtwarzalnymi z logów promptów, wagę liczoną po skutku (dane, akcja, koszt), zalecenia i retest.
Co trzeba przygotować przed testem aplikacji z modelem językowym?
Przed testem trzeba opisać otoczenie modelu: źródła kontekstu, narzędzia i ich uprawnienia.
- System prompt i lista źródeł kontekstu. Pełna treść promptu oraz spis RAG, pamięci, plików i innych danych wstrzykiwanych do rozmowy.
- Lista narzędzi i funkcji. Każde narzędzie, które model może wywołać, z uprawnieniami i kontem, na którym działa. Sposób opisania aplikacji przed testem pokazuje wpis o zakresie audytu aplikacji webowej i przygotowaniu do niego.
- Środowisko testowe z limitem kosztów. Osobna instancja z logowaniem promptów i odpowiedzi, aby każde ustalenie dało się odtworzyć.
- Decyzja o zatwierdzaniu działań. Które akcje agenta wymagają potwierdzenia człowieka, a które wykonują się automatycznie.
- Zakres testu. Sama aplikacja wokół modelu czy także model, w tym odporność na jailbreak.
W projektach, które prowadzimy, najczęściej ustalenia nie dotyczą samego modelu. Dotyczą narzędzi z prawem zapisu tam, gdzie zadanie wymaga tylko odczytu, oraz treści z zewnątrz, która trafia do kontekstu bez oznaczenia pochodzenia.
Najczęstsze pytania o testy penetracyjne aplikacji LLM
Czy prompt injection da się całkowicie wyeliminować?
Nie. OWASP w opisie LLM01 wskazuje między innymi ograniczenie zachowania modelu, filtrowanie wejścia i wyjścia, najmniejsze uprawnienia, zatwierdzanie działań wysokiego ryzyka i testy adwersaryjne. Według OWASP Cheat Sheet Series atakujący z dostatecznymi zasobami obliczeniowymi jest w stanie obejść większość obecnych zabezpieczeń. Dlatego liczy się ograniczenie skutków udanego wstrzyknięcia, a nie sama blokada.
Czy test obejmuje sam model, czy aplikację wokół niego?
Domyślnie aplikację wokół modelu, bo na tę warstwę zespół ma bezpośredni wpływ: może zmienić prompt, odebrać narzędziu uprawnienie albo dodać zatwierdzanie akcji. Testy samego modelu, na przykład odporności na jailbreak, stanowią osobny zakres; NIST AI 100-2 E2025 opisuje taksonomię takich ataków.
Czy prosty chatbot na stronie bez narzędzi też wymaga testu?
Tak, choć zakres jest węższy. Tester sprawdza ujawnienie system promptu i ukrytego kontekstu, nieograniczone zużycie tokenów i kosztów, dezinformację w odpowiedziach oraz obsługę wyjścia w przeglądarce, na przykład wstrzyknięcie skryptu przez odpowiedź modelu. Bez narzędzi odpada ryzyko nadmiernej sprawczości, ale pozostałe klasy nadal obowiązują.
Ile kosztuje test penetracyjny aplikacji LLM?
Nie podajemy liczby w artykule, bo cena zależy od kilku zmiennych. Najważniejsze to liczba narzędzi i integracji dostępnych dla modelu, liczba źródeł kontekstu, obecność samego modelu w zakresie oraz retest po poprawkach. Wstępny zakres i pytania o wycenę najlepiej przejść przez konfigurator zakresu testu.
Jak Pentestica może pomóc
Pentestica testuje aplikacje oparte na modelach językowych według OWASP LLM Top 10, a ich warstwę webową i API według OWASP WSTG i ASVS. Szczegóły podejścia opisuje usługa testów penetracyjnych aplikacji i API. Zespół ma ponad 10 lat doświadczenia i setki zrealizowanych projektów, których przykłady opisują studia przypadków. Zakres, w tym listę narzędzi i źródeł kontekstu, pomaga ustalić konfigurator zakresu testu.
Źródła
- OWASP GenAI Security Project, OWASP GenAI LLM Top 10 2026 – lista dziesięciu klas ryzyka dla aplikacji z modelami językowymi, edycja 2026
- OWASP Top 10 for LLM Applications 2025 – poprzednia edycja listy z listopada 2024
- OWASP, LLM01:2025 Prompt Injection (edycja 2025) – definicja bezpośredniego i pośredniego wstrzyknięcia oraz siedem strategii ograniczania
- OWASP Cheat Sheet Series, LLM Prompt Injection Prevention – zalecenia obronne dla zespołów wdrażających
- NIST AI 100-2 E2025, Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations – taksonomia ataków na systemy uczenia maszynowego, marzec 2025
- NIST NVD, CVE-2025-32711 – wpis o podatności w Microsoft 365 Copilot z czerwca 2025

Redakcja Pentestica to zespół pentesterów i konsultantów bezpieczeństwa, którzy na co dzień wykonują testy penetracyjne, testy TLPT wymagane przez DORA, red teaming i audyty bezpieczeństwa IT, a także prowadzą wdrożenia zgodności z NIS2, DORA i MiCA. Teksty na tym blogu piszemy z tej praktyki, a nie z opracowań. Każde twierdzenie o przepisie, terminie albo karze opieramy na źródle pierwotnym: dzienniku ustaw, tekście dyrektywy, komunikacie organu nadzoru. Jeśli czegoś nie da się potwierdzić, piszemy o tym wprost, zamiast powtarzać liczbę krążącą po branżowych portalach.